装了蜘蛛记录插件之后,第一次认真看了后台的「被爬页面清单」。
结果发现一堆奇怪的记录:
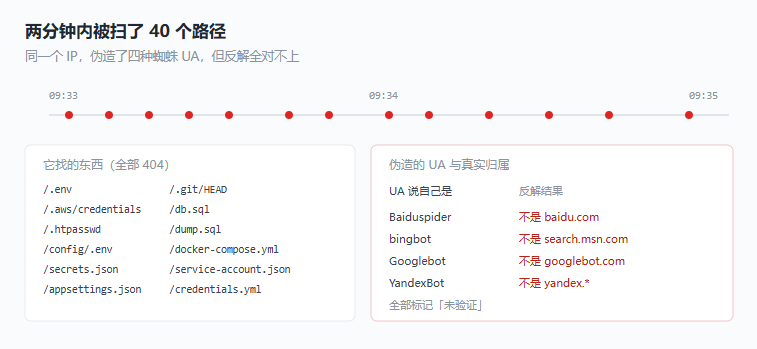
/.env              /.git/HEAD
/.aws/credentials  /db.sql
/.htpasswd         /dump.sql
/config/.env       /docker-compose.yml
/secrets.json      /service-account.json
两分钟,40 个路径,全部来自同一个 IP。
它伪装了四种蜘蛛
最开始我以为是搜索引擎在抓,因为 UA 显示:
Baiduspider
bingbot
Googlebot
YandexBot
但我的插件做了反向 DNS 验证,结果全部标记「未验证」。
因为反解出来的域名,和这些蜘蛛的官方域名对不上:
| UA 声称 | 应该反解成 | 实际 |
|---|---|---|
| Baiduspider | *.baidu.com |
不是 |
| bingbot | *.search.msn.com |
不是 |
| Googlebot | *.googlebot.com |
不是 |
| YandexBot | *.yandex.* |
不是 |
同一个 IP,四种 UA,全部伪造。
它在找什么
按目标分类:
| 类型 | 文件 | 想拿到什么 |
|---|---|---|
| 环境变量 | .env、env.txt、environment.json |
数据库密码、API Key |
| 版本控制 | .git/HEAD |
源码历史 |
| 云凭证 | .aws/credentials、service-account.json |
云账号权限 |
| 数据库备份 | db.sql、dump.sql |
整站数据 |
| 框架配置 | docker-compose.yml、appsettings.json |
部署结构 |
这是标准的「配置文件泄露扫描」,自动化脚本,不针对具体目标。
好消息:它什么都没拿到
40 个请求,全部 404。
因为这些文件我本来就没建过:
- WordPress 不用
.env - 没初始化过 Git
- 数据库备份放在
/www/backup,不在网站根目录
「文件不存在」是最有效的防御。
我做了什么
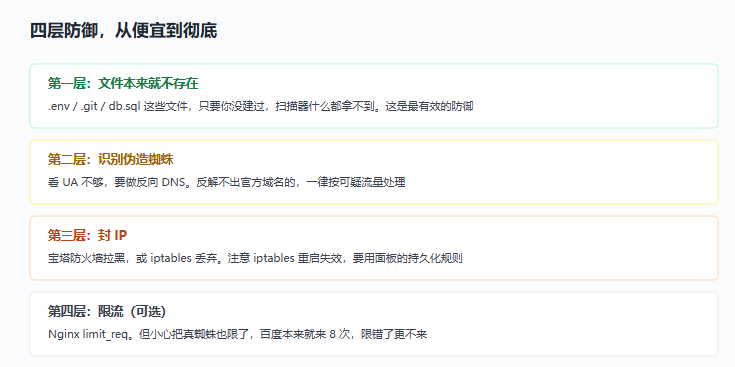
第一层:确认文件确实不存在
cd /www/wwwroot/你的站
ls -la | grep -E "\.env|\.git|sql$"
# 没有输出就安全
第二层:封 IP
宝塔 → 安全 → 防火墙 → IP 黑名单,把扫描器 IP 加进去。
别用 iptables,重启就失效,宝塔的规则会持久化。
第三层:开启蜘蛛验证
如果你也装了蜘蛛记录插件,确认 rDNS 验证是开着的。
没有这一步,你会把所有扫描器都当成搜索引擎。
第四层:考虑限流(可选)
Nginx 的 limit_req 能限制单 IP 频率,但小心把真蜘蛛也限了。
百度一年只来 8 次,限错了更不来。
一个反直觉的事实
开 HTTPS 会让你更容易被发现。
因为签发证书时会写进「证书透明度日志」(CT Log),这是公开的,扫描器实时监听。
新域名一上线,几小时内就会有扫描器来拜访。
但这不代表不该开 HTTPS——不开的话会被运营商劫持、被搜索引擎降权,代价更大。
真正要担心的
不是「被扫」,是「被扫到了东西」。
| 情况 | 严重程度 |
|---|---|
| 扫描器来了,全部 404 | 正常,不用管 |
/.env 返回 200 |
严重,立刻处理 |
/db.sql 能下载 |
灾难,数据库已经泄露 |
定期检查:
grep -E "\.env|sql|git" /www/wwwlogs/你的域名.log | grep -v " 404 " | tail -20这条命令找的是「扫了但没返回 404」的请求。有输出就要立刻查。
1、本站所有资源均收集于互联网,分享目的仅限学习与参考。如有侵权,请联系 1685698671@qq.com 及时删除!
2、本站资源不保证完整性和安全性,下载后请自行检测。使用过程中出现的任何问题均与本站无关,敬请自行处理。
3、本站资源仅限个人学习研究使用,严禁用于任何违法违纪用途。因使用者违规使用产生的一切后果,由使用者自行承担,本站不承担任何责任。


评论(0)